

Jeder Einkauf, den eine Organisation tätigt, hinterlässt eine Datenspur. Der Lieferant, an den die Bestellung geht, das Material oder die Dienstleistung, die gekauft wird, der vereinbarte Preis, die Lieferadresse, die Zahlungsbedingungen. Wenn diese Informationen korrekt und konsistent sind, läuft der Einkauf ruhig und vorhersehbar im Hintergrund ab. Wenn sie über Tabellenkalkulationen und teilweise ausgefüllte ERP-Felder verstreut sind, erscheint derselbe Lieferant dreimal unter drei verschiedenen Schreibweisen, und niemand kann mit Sicherheit sagen, wie viel das Unternehmen tatsächlich mit ihm ausgibt.
Beschaffungsstammdaten sind die Referenzinformationen, die zwei grundlegende Fragen für ein Unternehmen beantworten: von wem kaufen wir ein, und was kaufen wir ein. Dieser Artikel erklärt, was dazu gehört, warum es echtes finanzielles Gewicht hat, und wie es sich zu Produktinformationsmanagement verhält, einer Disziplin, mit der es häufig verwechselt wird.
Was Beschaffungsstammdaten umfassen
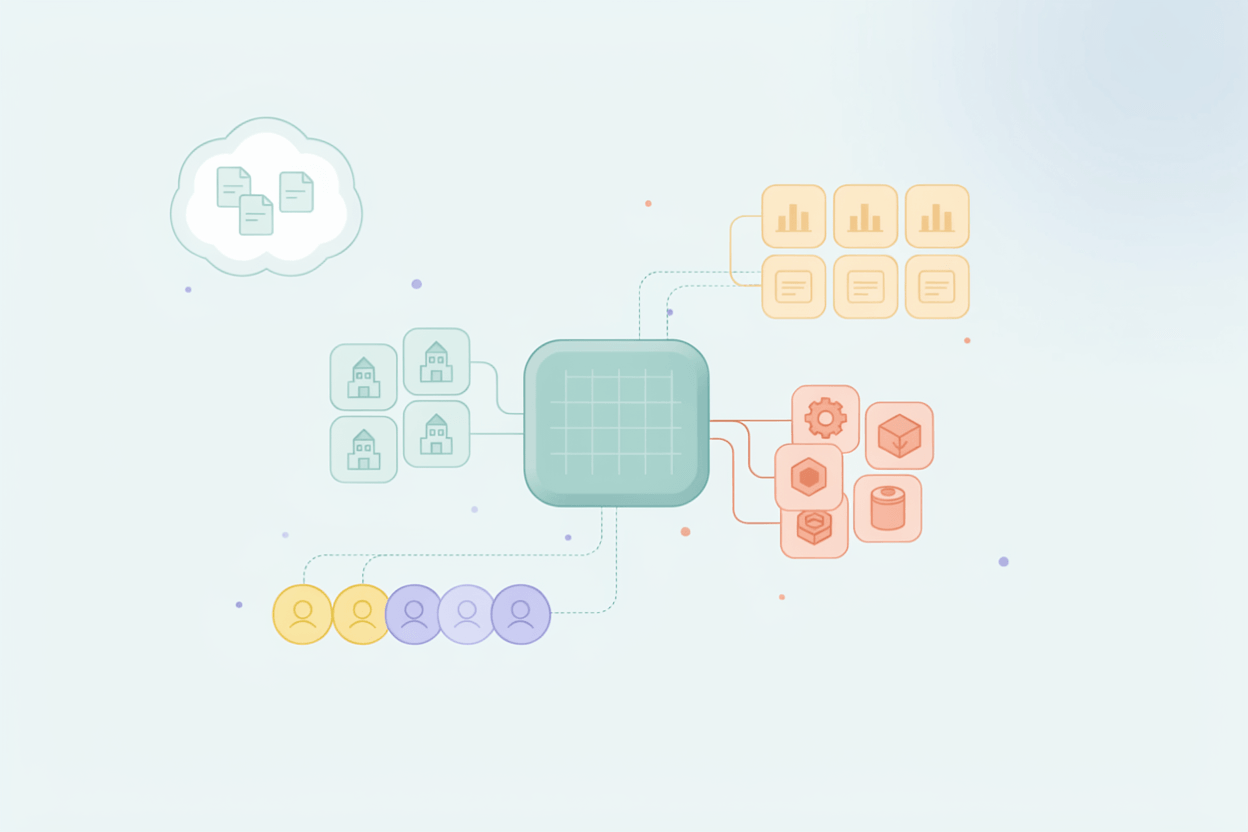
Beschaffungsstammdaten sind der Satz stabiler, wiederverwendbarer Datensätze, auf die Einkauf und Finanzen bei jeder Transaktion angewiesen sind. Sie ändern sich nicht mit jeder einzelnen Bestellung. Stattdessen liegen sie unter den Bestellungen und geben ihnen Bedeutung, genauso wie eine Kontaktliste unter den Anrufen liegt, die Sie tätigen.
Zwei Datensatztypen bilden den Kern:
- Der Lieferantenstamm (auch als Vendor Master bekannt) ist der verbindliche Datensatz für jedes Unternehmen, von dem Sie einkaufen. Er enthält die juristische Person hinter dem Lieferantennamen, Adressen, Steueridentifikatoren, Bankdaten, Zertifizierungen und vereinbarte Zahlungsbedingungen.
- Der Materialstamm (oder Artikelstamm auf der Einkaufsseite) beschreibt, was Sie beschaffen. Er enthält Artikelnummern, Maßeinheiten, Einkaufskategorien und die technischen Spezifikationen, die ein Einkäufer benötigt, um den richtigen Artikel zu bestellen und nicht etwas Ähnliches.
Um diese beiden Datensätze herum liegen Einkaufsbedingungen, Vertragsreferenzen und die Kategorieklassifizierungen, die einzelne Ausgaben mit dem breiteren Unternehmen verbinden. All dies teilt eine definierende Eigenschaft. Beschaffungsstammdaten werden ständig wiederverwendet, daher wiederholt sich ein Fehler in einem einzelnen Datensatz stillschweigend über Hunderte von nachgelagerten Transaktionen.
Warum Beschaffungsstammdaten finanzielles Gewicht tragen
Schwache Referenzdaten sind teuer auf eine Weise, die selten als einzelne, sichtbare Position erscheint. Sie verursachen Wertverlust über viele kleine Ereignisse verteilt, und die Menschen, die den Einkauf leiten, spüren dies direkt. In Deloittes Global Chief Procurement Officer Survey beurteilten Beschaffungsleiter mangelnde Datenqualität als das Haupthindernis für die effektive Anwendung von Technologie im Einkauf, noch vor schwacher Integration zwischen Anwendungen und mangelnder Finanzierung. Die Analysen, die Automatisierung und die KI, die ein modernes Team betreiben möchte, basieren alle auf den oben beschriebenen Lieferanten- und Materialdatensätzen. Wenn diese Datensätze fehlerhaft sind, erben alle darauf aufgebauten Systeme den Fehler.
Doppelte Lieferantendatensätze zeigen, wie sich dies speziell im Einkauf auswirkt. Wenn ein Lieferant zweimal im System unter leicht unterschiedlichen Schreibweisen vorhanden ist, erkennen die meisten Softwarekontrollen nur eine doppelte Rechnung innerhalb derselben Lieferantennummer. Eine gegen den zweiten Datensatz eingegebene Rechnung kann dann ein zweites Mal bezahlt werden, ohne dass etwas diese Situation kennzeichnet. Das Washington State Auditor's Office gibt unter Bezugnahme auf Branchenfiguren an, dass Doppelzahlungen zwischen 0,8 % und 2 % der Gesamtzahlungen ausmachen, und verweist direkt auf ungeordnete Lieferantenstammdateien als Ursache. Bei großem jährlichen Ausgabenvolumen werden Bruchteile eines Prozentsatzes zu einer summe, die es wert ist, sie zurückzugewinnen.
Ein einzelner Lieferant, der über zwei Datensätze dupliziert ist, ist kein kosmetisches Problem. Es ist eine stehende Einladung, dieselbe Rechnung zweimal zu bezahlen.
Wie sich Beschaffungsstammdaten von Produktinformationsmanagement unterscheiden
Die Verwechslung mit Produktinformationsmanagement beginnt oft mit einem gemeinsamen Wort. Beide Disziplinen befassen sich mit sogenannten „Produkt"-Daten, und beide zielen auf einen einzigen vertrauenswürdigen Datensatz ab. Was sie trennt, ist weniger die zugrunde liegenden Daten als vielmehr die Zielgruppe, die jede von ihnen bedient.
Produktinformationsmanagement, normalerweise implementiert über ein PIM-System, verwaltet die nach außen gerichteten Informationen über die Produkte, die ein Unternehmen verkauft. Marketingbeschreibungen, Bilder, technische Attribute, Übersetzungen und kanalspezifische Inhalte liegen alle in einem PIM-System. Seine Zielgruppe ist der Markt: Kunden, Vertriebsteams, Online-Marktplätze und Webshops. Sein Zweck ist es, Produkte reichhaltig und konsistent überall dort zu präsentieren, wo sie verkauft werden.
Beschaffungsstammdaten schauen in die andere Richtung. Sie verwalten die nach innen gerichteten Informationen über das, was ein Unternehmen kauft, und wer es liefert. Die Zielgruppe sitzt innerhalb des Unternehmens: Einkäufer, Kategorieverantwortliche, Kreditorenbuchhaltung und Prüfer. Ihr Zweck ist der Einkauf, der genau, kontrolliert und konform ist.
Die Unterscheidung ist wichtig, weil die beiden von verschiedenen Personen geleitet werden, gegen unterschiedliche Ziele gemessen werden und nach unterschiedlichen Definitionen von „gut" beurteilt werden. Ein PIM-Datensatz ist gut, wenn er dem Unternehmen beim Verkauf hilft. Ein Beschaffungsdatensatz ist gut, wenn er dem Unternehmen hilft, ohne Fehler oder Risiko zu kaufen. Diese Aufteilung ist real, aber es ist keine Mauer. Ein einzelner physischer Artikel kann gleichzeitig eine Verkaufsidentität und eine Kaufidentität tragen, was die Schnittstelle ist, an der sich die beiden Disziplinen treffen müssen.
| Produktinformationsmanagement (PIM) | Beschaffungsstammdaten | |
|---|---|---|
| Ausrichtung | Nach außen, zum Markt hin | Nach innen, zum Unternehmen hin |
| Kerndatensätze | Verkaufsprodukte und deren Inhalte | Lieferanten und gekaufte Materialien |
| Hauptzielgruppe | Kunden, Vertrieb, Marktplätze | Einkäufer, Finanzen, Prüfer |
| Erfolg sieht aus wie | Reichhaltige, konsistente Verkaufsinhalte | Genauer, risikoarmer Einkauf |
PIM beantwortet eine Kundenfrage zu einem Produkt. Beschaffungsstammdaten beantworten eine Einkäuferfrage zu einer Beschaffung.
Wo die beiden aufeinandertreffen und wie sie nebeneinander existieren
Diese Schnittstelle ist dort, wo sich der meiste praktische Wert befindet, und wo die frühere Unterscheidung aufhört, ein Grund zu sein, die beiden Systeme getrennt zu halten. Die Behandlung von PIM und Beschaffungsstammdaten als konkurrierende Tools ist ein häufiger und kostspieliger Fehler. Sie bedienen verschiedene Zielgruppen, lehnen sich aber auf überlappende Daten, und die Überlappung ist das Produkt selbst.
Ein Fertigprodukt, das ein Hersteller über seine PIM verkauft, wird normalerweise aus Komponenten, Rohstoffen und Verpackung zusammengebaut, die derselbe Hersteller über Beschaffung kauft. Ein einzelner physischer Artikel kann gleichzeitig ein „Produkt" für die Vertriebsorganisation und ein „gekauftes Material" für das Beschaffungsteam sein, beschrieben durch unterschiedliche Attribute aus unterschiedlichen Gründen. Die Abmessungen, die ein Einkäufer für eine Komponente aufzeichnet, sind oft genau die Abmessungen, die das Marketing später für das Fertigprodukt benötigt. Wenn diese in getrennten Systemen liegen, wird dieselbe Information zweimal eingegeben, und die beiden Kopien driften im Laufe der Zeit auseinander.
Ein Master Data Management-Ansatz verbindet die beiden Bereiche, sodass eine einmal vorgenommene Änderung überall dort fließt, wo sie benötigt wird. Master Data Management oder MDM ist die Praxis, eine verwaltete Quelle für die Daten zu führen, auf die mehrere Systeme und Teams angewiesen sind. Angewendet hier bedeutet dies, dass der Lieferantendatensatz, der Materialdatensatz und der Produktdatensatz verknüpft bleiben, anstatt in jedes System neu eingegeben zu werden, das eine Kopie haben möchte.
Warum die Verknüpfung von Datensätzen schwieriger ist als es klingt
Die Verbindung von Lieferanten-, Material- und Produktdatensätzen klingt nach Rohrleitungsarbeit. In der Praxis ist es dort, wo diese Projekte steckenbleiben, weil die beiden Seiten nie dafür gedacht waren, zusammenzupassen.
Ein ERP-Materialstamm ist für Transaktionen ausgelegt. Er ist durch eine interne Materialnummer verschlüsselt und enthält nur die Attribute, die Einkauf und Finanzen tatsächlich benötigen, und behandelt einen Artikel als einen flachen Datensatz. Ein PIM ist zum Verkaufen ausgelegt. Es ist attributreich, in Hierarchien und Varianten organisiert, in mehrere Sprachen lokalisiert, und es modelliert oft ein Marketingprodukt als eine Familie verwandter Artikel. Die Zuordnung zwischen den beiden ist selten eins-zu-eins. Ein einzelnes gekauftes Material kann in vielen verkaufbaren Produkten erscheinen, und ein verkauftes Produkt kann mehrere gekaufte Komponenten bündeln. Auch kein gemeinsamer Schlüssel lässt Sie sie automatisch abgleichen. Die Teilenummer des Lieferanten, der interne Materialcode und die marktgerichtete Produkt-ID weisen alle auf dasselbe Objekt hin, ohne sich auf dessen Namen zu einigen.
Zuständigkeit ist die andere Hälfte des Problems. Beschaffung und Finanzen kontrollieren die Material- und Lieferantendatensätze im ERP, und sie ändern sie durch langsame, bewusste Genehmigungsworkflows. Marketing kontrolliert das Produkt im PIM und ändert es schnell. Wenn beide eine Version desselben Attributs, des Gewichts oder der Abmessungen eines Artikels halten, muss jemand entscheiden, wessen Wert autoritativ ist, und was geschieht, wenn die beiden nicht übereinstimmen. Das ist eine Governance-Frage in technischem Gewand, und keine Softwarebestellung beantwortet sie.
Die Teams, mit denen wir zusammengearbeitet haben, haben selten Schwierigkeiten mit der Idee, dass diese Datensätze verbunden sein sollten. Sie haben Schwierigkeiten mit der Abstimmung: manueller Abgleich von Legacy-Duplikaten und Festlegung, welches System welches Feld besitzt, bevor etwas verknüpft wird. Ein Tool wie AtroPIM kann beide Bereiche an einem Ort modellieren und die mechanische Neueingabe überflüssig machen, aber es wird nicht die Zuständigkeitsfragen für Sie lösen. Jemand muss das immer noch tun.
Wann Sie sie getrennt lassen sollten
All das bedeutet nicht, dass jedes Unternehmen die beiden zusammenführen sollte. Die Produktbrücke existiert nur, wenn das, was Sie kaufen, tatsächlich zum Verkauf wird. Ein Hersteller, der gekaufte Komponenten in Fertigprodukte umwandelt, hat eine starke Überlappung und einen echten Fall für Verknüpfung. Ein Unternehmen, dessen Ausgaben überwiegend indirekt sind, wie etwa Facility-Verträge und professionelle Dienstleistungen, hat für die meisten seiner Lieferanten- und Materialdaten keine produktseitige Entsprechung, daher bringt ein gemeinsames Modell sehr wenig Nutzen.
Der Umfang zählt genauso viel wie die Überlappung. Master Data Management zahlt sich aus, wenn Daten über mehrere Systeme verteilt sind und das Volumen hoch genug ist, dass Duplizierung echtes Geld kostet. Ein Unternehmen, das ein einigermaßen sauberes ERP betreibt, mit einem stabilen Lieferantenstamm und einem bescheidenen Katalog, wird oft mehr davon bekommen, die Regeln auf diesem einzelnen System zu verschärfen, als eine verwaltete Schicht darüber zu bauen. Die Integrationsarbeit und die laufende Steuerung, die MDM erfordert, sind nicht kostenlos, und unterhalb einer bestimmten Schwelle kosten sie mehr als die Lecks, die sie verhindern. Der ehrliche Test ist, ob Fragmentierung Sie messbar schadet, nicht ob eine einzige Quelle der Wahrheit abstrakt ansprechend klingt.
Wo Sie beginnen sollten
Der erste Schritt ist nicht die Softwareauswahl. Es geht darum, zu entscheiden, wer für was zuständig ist. Einigen Sie sich darauf, wer einen Lieferanten erstellen kann, wer ein neues Material genehmigt, und was ein Datensatz enthalten muss, bevor jemand ihn verwenden darf. Fast alle Duplikationen, die später Geld kosten, beginnen als Lücke in diesen Regeln.
Ein kurzer Satz von Fragen legt normalerweise offen, wo das Risiko tatsächlich liegt:
- Wer kann heute einen Lieferantendatensatz erstellen und bearbeiten, und wie viele Menschen sind das in der Praxis?
- Existiert ein einzelner physischer Artikel jemals unter mehr als einem Code, und würde jemand es bemerken, wenn es so wäre?
- Wenn sich eine Spezifikation ändert, wie lange dauert es, bis sie sowohl den Einkäufer als auch das Produktteam erreicht?
Sobald diese Antworten klar sind, hat Software eine definierte Aufgabe. Sie setzt die Regeln durch, die Sie festgelegt haben, und hält die verknüpften Datensätze in Schritt, anstatt aufgefordert zu werden, eine Struktur zu erfinden, auf die sich niemand geeinigt hat. Wenn Sie diese Reihenfolge falsch machen, kann die sauberste Plattform innerhalb eines Jahres in Tabellenkalkulationen zurückverwandelt werden.
Beschaffungsstammdaten sind der Satz stabiler, wiederverwendbarer Datensätze, auf die Einkauf und Finanzen bei jeder Transaktion angewiesen sind. Sie ändern sich nicht mit jeder Bestellung. Stattdessen liegen sie unter den Bestellungen und geben ihnen Bedeutung, genauso wie eine Kontaktliste unter den Anrufen liegt, die Sie tätigen.