

Key Takeaways
- Ein PIM-Datenmodell definiert die Entitäten, Attribute und Beziehungen in Ihrer Produktdomäne. Es ist eine Designentscheidung, nicht ein Datenbankdetail.
- Kernentitäten (Produkt, Variante, Klassifizierung, Kategorie, Asset, Kanal, Sprache) müssen getrennt bleiben. Sie in einem Record zusammenzufassen führt zu struktureller technischer Schuld, die sich mit jedem neuen Produkttyp oder Kanal vergrößert.
- Der Attribut-Scope (global, sprachspezifisch, kanalspezifisch) ist die kritischste Modellierungsentscheidung. Fehler dabei beschädigen die Publishing-Logik in jeder nachgelagerten Integration.
- Modelldrift ist ein häufiger Ausfallmodus: Attribute werden außerhalb von Klassifizierungen hinzugefügt, Vollständigkeitsregeln nicht aktualisiert, Dokumentation veraltet. Ein benannter Modell-Owner verhindert das.
- Strukturelle Probleme im Datenmodell wirken sich auf jeden Produktdatensatz, jeden Export und jede Integration aus. Sie in der Produktion zu beheben kostet ein Vielfaches dessen, sie von Anfang an richtig zu gestalten.
Ein Produktinformationsmanagement-Datenmodell ist das strukturelle Fundament, auf dem Ihre Produktinformationen aufgebaut sind. Bevor Sie Workflows konfigurieren, Import-Pipelines aufsetzen oder Publishing-Regeln definieren, bestimmt es, welche Entitäten existieren, wie sie sich zueinander verhalten und welche Attribute wohin gehören. Machen Sie es von Anfang an richtig, wird alles Nachgelagerte einfacher. Machen Sie es falsch, multipliziert sich der Aufwand mit jedem neuen Produkttyp, Kanal oder Markt, den Sie hinzufügen.
Was ein Produktinformationsmanagement-Datenmodell wirklich ist
Ein Datenmodell ist die konzeptionelle Ebene über dem Datenbankschema. Das Schema ist die technische Implementierung. Das Modell ist das Design, das es treibt.
Im PIM-Kontext beschreibt das Produktinformationsmanagement-Datenmodell jede Entität in Ihrer Produktdomäne, die Attribute, die diese Entitäten beschreiben, und die Beziehungen zwischen ihnen. Es entscheidet, ob eine Farbe ein Feld im Produktdatensatz ist oder eine Dimension, die unterschiedliche Varianten erzeugt. Es bestimmt, ob eine technische Spezifikation zum Produkt selbst oder zu seiner Klassifizierung gehört, und ob ein Preis ein zentrales Produktattribut oder eine separate verlinkte Entität ist.
In der Praxis bestimmen diese Entscheidungen, ob Ihr Katalog mit dem Wachstum wartbar bleibt oder zu einem teuren Durcheinander wird, das Sie umstrukturieren müssen.
Die fehlende explizite Datendefinition war in Projekten, zu deren Lösung wir hinzugezogen wurden, fast immer die Grundursache von Produktdatenqualitätsproblemen. Teams fügen Attribute überall dort ein, wo sie passen, Identifikatoren werden dupliziert, und kanalspezifische Daten vermischen sich mit zentralen Datensätzen.
Kernentitäten in einem Produktinformationsmanagement-Datenmodell
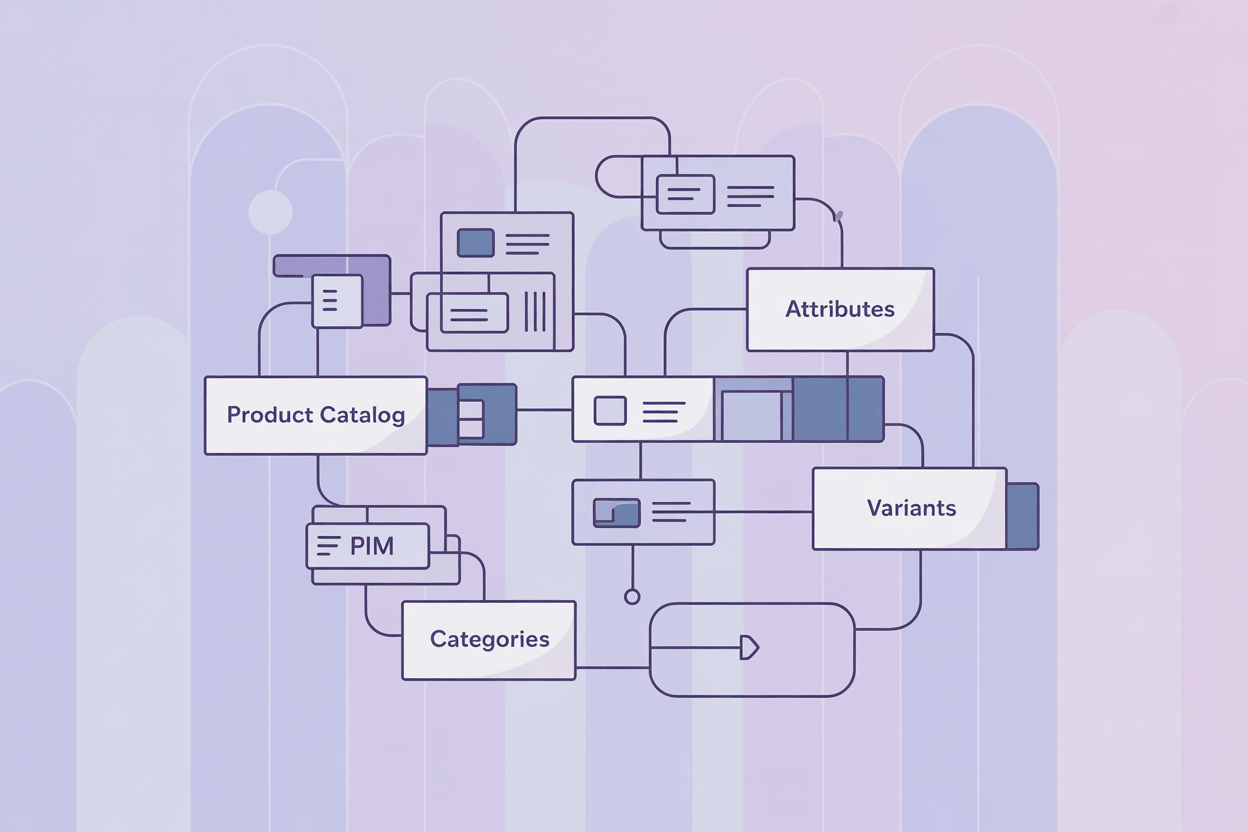
Ein gut gestaltetes PIM-Datenmodell behandelt die folgenden als getrennte Entitäten, nicht als in einen einzigen Produktdatensatz zusammengefasst. Jede repräsentiert eine separate Domäne von Masterdaten mit ihrem eigenen Lebenszyklus und ihrer eigenen Verantwortlichkeit.
Produkt. Die Basiseinheit. Enthält Identifikatoren (interne ID, SKU, GTIN/EAN, MPN), zentrale deskriptive Felder und globale Attribute, die über alle Kanäle und Sprachen hinweg geteilt werden. Dieser Datensatz ist die Masterreferenz. Er trägt keine Sprach-Overrides oder kanalspezifische Inhalte direkt.
Produktvariante. Eine separate Entität, die mit dem übergeordneten Produkt über eine Parent-Child-Beziehung verlinkt ist. Jede Variante bekommt ihre eigene SKU und ihre eigene bestandsverfolgbare Identität. Die Variante erbt geteilte Attribute vom übergeordneten Produkt und trägt nur die Attribute, die sie unterscheiden, wie Größe oder Farbe. Varianten mit konfigurierbaren Optionen (Dinge, die zur Bestellzeit angewendet werden, wie benutzerdefinierte Gravur) zu vermischen ist einer der häufigsten Modellierungsfehler. Das führt zu SKU-Explosion oder zerstört die Bestandsverfolgung.
Klassifizierung und Attributset. Der Mechanismus, der eine Gruppe von Attributen einem Produkt basierend auf seinem Typ zuweist. Eine Industriepumpe und ein Schutzhelm brauchen völlig unterschiedliche Attributsets. Mit Klassifizierungen können Sie diese Sets einmal definieren und konsistent zuweisen, statt die gleichen Attribute manuell zu hunderten Datensätzen hinzuzufügen. Branchenstandardklassifikationen wie ETIM, ECLASS oder GS1 werden direkt auf diese Ebene abgebildet.
Kategorie. Die organisatorische Hierarchie, durch die Kunden navigieren. Kategorien sind nicht das Gleiche wie Klassifizierungen. Eine Kategorie bestimmt, wo ein Produkt im browsaren Baum lebt. Eine Klassifizierung bestimmt, welche Attribute darauf zutreffen. Viele Produktdatenmodelle verwechseln diese, was die Produkttaxonomie spröde macht.
Digitales Asset (DAM-Link). Bilder, Videos, PDFs, technische Zeichnungen und Zertifikate sind Entitäten in ihrem eigenen Recht, mit Produkten über eine Beziehung verlinkt statt eingebettet im Produktdatensatz, sodass das gleiche Asset über mehrere Produkte hinweg wiederverwendet und an einer Stelle aktualisiert werden kann.
Kanal. Das Ausgabeziel: ein Webshop, ein Marketplace, ein Katalog zum Drucken, ein B2B-Portal. Kanäle tragen ihre eigenen Attributkonfigurationen und Vollständigkeitsanforderungen. Zentrale Produktdaten bleiben im Basisdatensatz. Kanalspezifische Overrides sitzen in einer separaten verlinkten Struktur, damit Teams Inhalte pro Ziel anpassen können, ohne Masterdaten zu berühren.
Sprache. Sprach- und Regionalvarianten von Textattributen. Sprachspezifische Inhalte (Übersetzungen, regionale Beschreibungen, lokale Compliance-Text) leben in ihrem eigenen verlinkten Datensatz, nicht als parallele Spalten im Hauptproduktdatensatz.
Attribut-Scope: Die Designentscheidung, die die meisten Modelle bricht
Der Attribut-Scope ist die höchste Einsatzentscheidung in jedem Produktinformationsmanagement-Datenmodell. Jedes Attribut braucht einen definierten Scope, bevor Sie es zum Modell hinzufügen. Es gibt drei:
- Global. Der gleiche Wert gilt in allen Kanälen und Sprachen. Bruttogewicht, Materialzusammensetzung, GTIN.
- Sprachspezifisch. Der Wert variiert je nach Sprache oder Region. Produktname, Marketingbeschreibung, Compliance-Text.
- Kanalspezifisch. Der Wert gilt nur in einem bestimmten Output-Kanal. Kurzbeschreibung für ein Marketplace-Listing, druckfertige Headline für einen Katalog.
Den Scope falsch zu bekommen bricht die nachgelagerte Publishing-Logik. Ein Produktname, der als global gekennzeichnet ist, wird den gleichen Text auf jeden Markt veröffentlichen. Eine technische Spezifikation, die als kanalspezifisch zugewiesen wird, erreicht möglicherweise nicht die ERP-Integration, die sie braucht.
Gartner-Forschung schätzt, dass schlechte Datenqualität Organisationen durchschnittlich 12,9 Millionen Dollar pro Jahr kostet. Bei Produktdaten lässt sich ein großer Teil dieser Kosten auf strukturell fehlplatzierte Daten zurückführen: korrekte Werte, die gegen den falschen Scope, die falsche Entität oder die falsche Attributdefinition gespeichert sind.
Attributtypen sind auch wichtig. Ein Nur-Text-Feld, ein numerisches Feld mit Einheit, ein kontrolliertes Vokabular (Single-Select Enum), ein Multi-Select, ein Boolean, eine Asset-Referenz: jede hat verschiedene Validierungslogik und unterschiedliches Verhalten nachgelagert in Exporten, Marketplace-Feeds und Print-Templates. Systeme wie AtroPIM bieten mehr als 20 Attributtypen mit typspezifischer Validierung, die den größten Teil der manuellen Datenverwaltungs-Belastung entfernen, die Spreadsheet-basiertes Katalogmanagement hinterlässt.
Hierarchien und Beziehungen
Die meisten komplexen Produktkataloge brauchen mehrstufige Hierarchien: Produktfamilien oben, Produktgruppen darunter, einzelne Produkte und ihre Varianten unten. Ein Baustoffhersteller könnte es als Befestigungsmittel > Holzschrauben > Holzschraube Senkkopf 4x40mm strukturieren, wobei jede Ebene ihr eigenes vererbtes Attributset trägt.
Das Hierarchie-Design bestimmt, wie die Attributvererbung funktioniert. Ein untergeordnetes Produkt kann geteilte Attribute von einem übergeordneten Produkt erben und nur das überschreiben, was sich unterscheidet, statt das vollständige Attributset auf jedem Datensatz zu duplizieren, was das Modell schlank hält, während der Katalog wächst.
Beziehungen zwischen Produkten sind ein separates Konzept. Zubehör, Ersatzteile, Ersatzoptionen, Upsell-Alternativen und Bundle-Komponenten sind alle sinnvolle Assoziationen in einem B2B-Produktkatalog. Ein Elektrogeräte-Hersteller muss beispielsweise ausdrücken, dass ein Leistungsschalter kompatible DIN-Schiennadapter hat und dass eine neue Sicherungsserie eine ältere ablöst. Diese Assoziationen sind nicht Attribute; sie sind typisierte Beziehungen zwischen Entitäten.
In Projekten, die wir für Hersteller von Industrieausrüstung implementiert haben, war das Fehlen expliziter Beziehungsmodellierung durchgehend dort, wo das Datenmodell zusammenbrach. Teams speicherten zugehörige Produkte als durch Kommas getrennte SKU-Strings in einem Textfeld, was funktionierte, bis sie diese Informationen auf strukturierte Weise filtern, anzeigen oder exportieren mussten.
Wo das Datenmodell lebt und wer es besitzt
Ein Produktinformationsmanagement-Datenmodell ist nicht nur ein Datenbankdiagramm in einem technischen Repository. Es muss ein lesbares Referenzdokument sein, das für Entwickler und Business-Stakeholder zugänglich ist, und jede Entität, jedes Attribut, jede Beziehung und jede Validierungsregel in klarer Sprache beschreiben. Dieses Dokument ist es, das die abteilungsübergreifende Abstimmung beibehält, während der Katalog sich entwickelt, und worauf sich jedes Datenverwaltungsprogramm für die Durchsetzung verlässt.
Ein Muster, das wir wiederholt sehen: Ein Hersteller führt eine PIM-Implementierung durch, der ursprüngliche Berater dokumentiert das Modell, und anderthalb Jahre später ist das Dokument veraltet. Produktmanager haben Attribute direkt auf Produktebene hinzugefügt, die über Klassifizierungen hätten gehen sollen. Neue Kanalkonfigurationen wurden erstellt, ohne Vollständigkeitsregeln zu aktualisieren. Das Modell ist von der Dokumentation abgewichen, und niemand hat ein zuverlässiges Bild davon, was das System tatsächlich enthält. Die Lösung ist, das Modell-Dokument als lebendes Artefakt mit einem benannten Owner zu behandeln, versioniert zusammen mit Systemänderungen.
Wenn Sie ein PIM- oder MDM-Projekt starten, ist der richtige erste Schritt ein Datenmodell-Audit: Kartografieren Sie Ihre aktuellen Entitäten, identifizieren Sie, wo Produktstammdaten inkonsistent gespeichert sind, und definieren Sie das Zielmodell, bevor Sie eine Systemkonfiguration anfassen. Daten in ein PIM zu importieren ohne ein definiertes Modell bedeutet, dass Sie die gleichen strukturellen Probleme in neue Infrastruktur migrieren.
Wie AtroPIM das Datenmodell implementiert
AtroPIM basiert auf der AtroCore-Plattform, die das Produktinformationsmanagement-Datenmodell als erstklassige Konfigurationsangelegenheit behandelt. Entitäten, Felder, Attributtypen, Beziehungen und Hierarchien sind alle über die Admin-Oberfläche konfigurierbar ohne benutzerdefinierte Entwicklung, sodass das Datenmodell zu einem Operational Artifact wird, das Business- und IT-Teams gemeinsam entwickeln können, statt eines gesperrten Schemas, das jedes Mal einen Entwickler benötigt, wenn ein neuer Produkttyp auftaucht.
Das System unterstützt Attribute, die auf drei Ebenen zugewiesen sind: direkt zu einem Produkt, über eine Klassifizierung oder über das übergeordnete Produkt durch Vererbung. Diese Flexibilität ist wichtig, wenn Sie Kataloge verwalten, wo Produkttypen erheblich variieren. Kunden, die von Spreadsheet-basierter Verwaltung oder starre Legacy-PIM-Systemen zu uns kommen, haben oft ein einziges flaches Attributschema, das über den gesamten Katalog angewendet wird. Ein Sicherheitsausrüstungsvertreiber, der sowohl persönliche Schutzausrüstung als auch Festinstallationshardware handhabt, kann diesen Ansatz nicht verwenden. AtroPIM verwaltet das über Klassifizierungen mit produkttypspezifischen Attributsets, jede mit ihren eigenen Pflichtfeldern und Vollständigkeitsregeln.
Kanäle in AtroPIM tragen ihre eigenen Attributkonfigurationen. Ein Produkt, das mit einem Webshop-Kanal und einem Print-Katalog-Kanal verlinkt ist, kann unterschiedliche erforderliche Felder pro Ziel haben, mit Vollständigkeit separat pro Kanal verfolgt. Diese Struktur ermöglicht es der Datenverwaltungsschicht, Qualitätsanforderungen spezifisch für jede Ausgabe durchzusetzen, statt One-Size-Fits-All-Validierungsregeln über den gesamten Katalog anzuwenden.
AtroPIM unterstützt auch benutzerdefinierte Entitäten über das Standard-Produktmodell hinaus. Teams, die Verträge, Zertifizierungen, Lieferantendatensätze oder Spezialangebote verwalten, können diese als erstklassige Entitäten im gleichen System erstellen, mit Beziehungen zurück zum Produktmodell. Das eingebaute DAM sitzt innerhalb des gleichen Datenmodells statt in einem separaten System mit loser Kopplung, sodass Assets direkt zu Produkten, Kategorien und anderen Entitäten als typisierte Beziehungen verlinken. Beide Fähigkeiten stammen aus der AtroCore-Grundlage, die für umfassendere Datenverwaltungsszenarien über einen klassischen PIM-Geltungsbereich hinaus entworfen ist.
Für Organisationen, die mit Industrie-Datenstandardsarbeiten, unterstützt AtroPIM ETIM, BMEcat, ECLASS und GS1 Formate in seinen Import- und Export-Feeds. Klassifizierungsstrukturen aus diesen Standards können direkt ins AtroPIM-Datenmodell abgebildet werden, was den manuellen Aufwand zur Anpassung von Katalogdaten an Vertreiber- oder Marketplace-Anforderungen reduziert.
Häufige Modellierungsfehler
Alles in einem Produktdatensatz zu flachen ist der teuerste, um ihn rückgängig zu machen. Varianten, Sprachen, Kanäle und Assets werden in einer breiten Tabelle mit hunderten Spalten zusammengefasst, handhabbar für kleine statische Kataloge, aber brechend in dem Moment, wenn Sie eine neue Sprache hinzufügen, auf einen neuen Kanal veröffentlichen oder Ihre Varianten-Logik umstrukturieren müssen.
Kategorien als Klassifizierungen zu verwenden vermischt zwei unterschiedliche Funktionen. Kategorien ändern sich, wenn sich die Navigationsstruktur ändert. Klassifizierungen ändern sich, wenn sich die Produkttypen ändern. Sie getrennt zu halten bedeutet, dass Sie die Storefront umorganisieren können, ohne die Attribut-Zuweisungslogik zu berühren, und umgekehrt.
Identifikatoren zu vermischen verursacht Reconciliation-Fehler über jede Integration. Interne ID, SKU, EAN/GTIN und MPN haben jeweils verschiedene Funktionen und verschiedene Umfänge über die Supply Chain. Eine MPN eines Herstellers ist nicht die gleiche wie eine SKU eines Verteilers, und beide unterscheiden sich von einer GTIN, die in einer GS1-Datenbank registriert ist. Eine systemübergreifende Mapping-Tabelle, die alle als unterschiedliche Felder hält, verlinkt zum Produktdatensatz, ist der richtige Ansatz. Nur einen Identifikator pro Produkt zu speichern führt zu Reconciliation-Problemen in jeder ERP- und Marketplace-Integration nachgelagert.
Die Kosten des Aufschiebens des Modells
Das praktische Argument für Investitionen ins Produktinformationsmanagement-Datenmodelldesign vor der Systemkonfiguration ist einfach: Ein strukturelles Problem im Modell wirkt auf jeden Produktdatensatz, jeden Export und jede Integration aus, die darauf aufbaut. Es später zu beheben bedeutet, das System neu zu konfigurieren, Daten erneut zu importieren und Integrationsmappings umzuschreiben. Das bedeutet auch, dass jeder Monat, in dem das fehlerhafte Modell in der Produktion ist, mehr Entscheidungen und Prozesse von seiner Struktur abhängen, was die spätere Behebung schwerer macht.
Gestalten Sie das Modell, bevor Sie das System konfigurieren. Die meisten Datenprobleme in Produktkatalogen sind Modellprobleme, keine Dateneingabeprobleme.
Ein Pre-Migration-Modell-Audit deckt typischerweise die gleichen Probleme auf: Attribute auf der falschen Ebene gespeichert, Klassifizierungslogik völlig fehlend, Identifikatoren über Felder dupliziert und kanalspezifische Inhalte in globalen Datensätzen. Keine davon sind Dateneingabefehler. Sie sind strukturelle Entscheidungen, die früh getroffen und dann jahrelang umgangen wurden. Organisationen, die explizite Entity-Strukturen, Attribut-Scopes und Beziehungstypen vor dem ersten Import definieren, geben durchgehend weniger Zeit für Nachbearbeitungen aus und erzeugen zuverlässigere Channel-Ausgaben. Strukturelle Entscheidungen, die am Anfang eines PIM-Projekts getroffen werden, kosten fast nichts, um auf Papier zu ändern, und viel, um in der Produktion zu ändern, was das Datenmodell zum höchst wirksamen Investitionspunkt in jede Produktinformationsmanagement-Initiative macht.